Acasă
» Știri
»
Renderizare vs. Rețea Akash: Ce model de calcul descentralizat se potrivește volumului dvs. de lucru?
Renderizare vs. Rețea Akash: Ce model de calcul descentralizat se potrivește volumului dvs. de lucru?
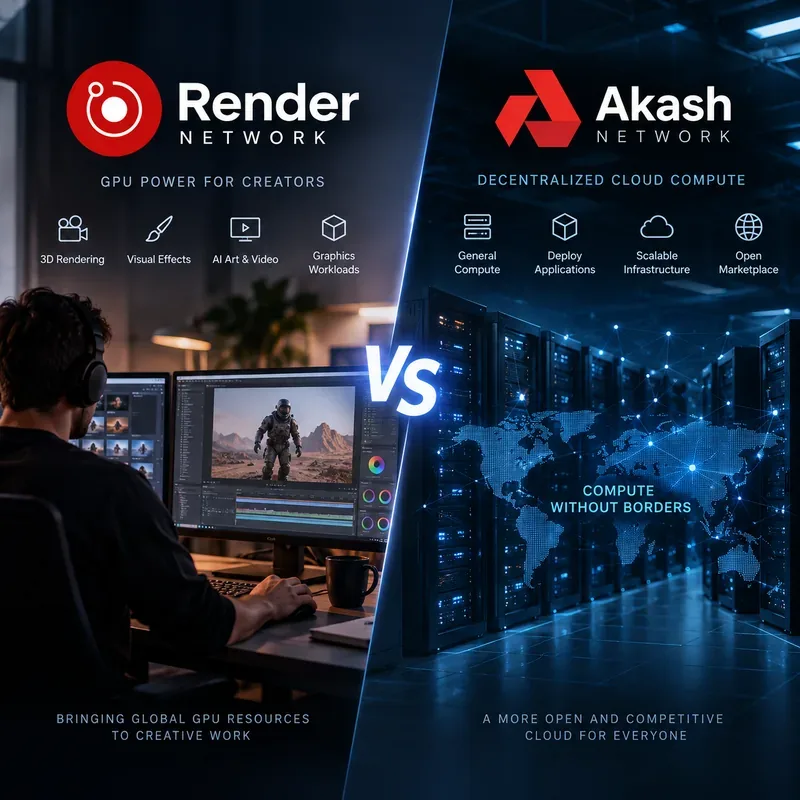
Cea mai importantă diferență este adaptarea la volumul de lucru: Render Network este cea mai puternică opțiune atunci când doriți o rețea GPU orientată către creatori pentru randare 3D, efecte vizuale, conținut spațial și media generativă integrată, în timp ce Akash Network este mai aproape de o piață cloud descentralizată generală, unde implementați containere și închiriați CPU, memorie, stocare, rețea și GPU-uri de la furnizori concurenți.
Asta înseamnă că nu există un răspuns util, într-un singur cuvânt, la „Render sau Akash?”. Un studio care încearcă să finalizeze o randare Octane, Redshift sau Blender Cycles are o problemă diferită față de un dezvoltator care încearcă să mențină online o API de inferență, o aplicație bazată pe o bază de date sau un container CUDA personalizat. Rețeaua mai bună este cea al cărei model de operare se potrivește cu sarcina.
Render Network este axat pe fluxuri de lucru creative care utilizează intens GPU, în timp ce Akash Network expune o piață mai largă pentru infrastructura de calcul containerizată.
Randare vs. Akash într-un singur tabel
Întrebare
Rețea de randare
Rețeaua Akash
Putere principală
Randare GPU distribuită și fluxuri de lucru generative axate pe creatori
Infrastructură cloud descentralizată de uz general
Unitate tipică de lucru
Randare scenă, job cadru, flux de lucru creativ sau AI acceptat
Implementare containerizată descrisă cu cerințe de CPU, RAM, stocare, GPU și rețea
Servicii web, API-uri, inferență AI, antrenament de modele, calcul în loturi, baze de date, aplicații GPU
Controlul GPU-ului
Controale orientate spre job, cum ar fi limitele motorului, VRAM-ului și GPU-ului în cadrul fluxurilor de lucru acceptate
Cereri orientate spre infrastructură, inclusiv modelul GPU, numărul și, acolo unde este disponibil, interconectarea GPU
Selectarea furnizorului
Platforma programează joburi compatibile pe nodurile de rețea
Furnizorii licitează pentru o implementare; chiriașul acceptă o ofertă și încheie un contract de închiriere
Când pare cel mai simplu
Folosești deja un instrument creativ compatibil și vrei să randezi fără a construi infrastructură cloud
Aveți deja un container și doriți control asupra implementării similar cu cel din cloud
Alegeți Randare când rezultatul este chiar lucrarea creativă
Render Network a fost construit în jurul randării GPU de înaltă performanță. Site-ul său oficial actual poziționează serviciul în jurul OctaneRender, Redshift și Blender Cycles, alături de instrumente de imagistică generativă bazate pe inteligență artificială. Rețeaua documentează, de asemenea, integrări cu software-uri importante pentru crearea de conținut digital, inclusiv Blender, Cinema 4D, Houdini, Maya, 3ds Max, Unity și Unreal Engine. Consultați site-ul oficial Render Network și pagina sa oficială de integrări .
Această specializare contează. Un creator nu închiriază pur și simplu un GPU brut. Fluxul de lucru include pregătirea scenei, trimiterea jobului, estimarea costurilor, randarea și recuperarea rezultatului. Pentru fluxurile de lucru Octane, documentația Render explică faptul că o scenă poate fi împachetată ca ORBX și trimisă în rețea. Render expune, de asemenea, controale precum VRAM minim și GPU-uri maxime pentru a ajuta la potrivirea scenelor complexe cu nodurile adecvate. Documentația oficială de pregătire a scenei și ghidul parametrilor avansați ai jobului descriu acest model în detaliu.
Un exemplu de randare concretă
Imaginați-vă un studio de design de mișcare care are o secvență Cinema 4D de 2.000 de cadre care se randează corect în Redshift, dar ar dura prea mult pe stațiile de lucru locale. Studioul nu trebuie să opereze un server web persistent sau să administreze Kubernetes. Are nevoie de cadre finalizate. Randarea este aliniată în mod natural cu această cerință, deoarece lucrarea poate fi tratată ca un job de randare, mai degrabă decât ca o implementare în cloud.
Testul practic al calității este simplu: poate fi scena pregătită într-un flux de lucru compatibil, distribuită cu succes și finalizată la un timp și un cost acceptabile, producând în același timp cadrele așteptate? Dacă da, pipeline-ul specializat reprezintă un avantaj. Dacă studioul se trezește încercând să ruleze servicii de lungă durată, fără legătură, în jurul jobului de randare, acesta este un semn că trebuie să evalueze o platformă de calcul mai generală.
Alege Akash atunci când ai nevoie de infrastructură, mai degrabă decât de o conductă de randare
Akash adoptă o abordare diferită. Documentația sa oficială descrie o piață descentralizată care conectează entitățile găzduite care au nevoie de resurse de calcul cu furnizorii care operează infrastructura. O implementare specifică serviciile și resursele necesare; se deschide o comandă; furnizorii depun oferte; entitatea găzduită selectează o ofertă; iar aplicația rulează în baza unui contract de leasing. Consultați documentația ciclului de viață al implementării Akash .
Definiția implementării este mult mai apropiată de infrastructura cloud decât de o coadă de randare. Limbajul de definire a stivei (SDL) de la Akash permite unui client găzduit să descrie imaginile containerelor, CPU-ul, memoria, stocarea, porturile expuse și cerințele GPU. Furnizorii pot oferi servicii de calcul CPU și GPU, stocare persistentă sau efemeră, conectivitate la rețea și contracte de închiriere IP opționale. Documentația furnizorului și a contractelor de închiriere explică modul în care funcționează aceste resurse și acorduri.
Un exemplu concret de Akash
Să presupunem că un dezvoltator a inclus în pachetul Docker o API de generare de imagini. Serviciul are nevoie de un GPU NVIDIA, 16 GB sau mai mult de memorie GPU, mai multe nuclee CPU, RAM, stocare persistentă și un endpoint public. Dezvoltatorul dorește ca serviciul să rămână online, în loc să dispară după finalizarea unui job batch.
Din punct de vedere structural, aceasta este o problemă în stilul Akash. Dezvoltatorul poate solicita o implementare GPU, poate selecta oferte de la furnizori compatibili, poate rula containerul și poate plăti cât timp contractul de leasing rămâne activ. Documentația actuală Akash pentru GPU acoperă în mod explicit antrenamentul, inferența, randarea și sarcinile de lucru științifice pentru inteligența artificială, inclusiv solicitările GPU specifice modelului și configurațiile multi-GPU. Consultați ghidul oficial de implementări GPU .
Dar ce se întâmplă cu inteligența artificială? Cele două rețele se suprapun din ce în ce mai mult
Comparația devine mai puțin binară în jurul inteligenței artificiale. Render nu se mai rezumă doar la randarea tradițională a cadrelor. Platforma sa actuală include instrumente de imagistică generativă, iar inițiativa sa Compute Client este destinată să sprijine aplicațiile terțe de învățare automată, inferență, reglare fină și inteligență artificială generativă. Render descrie această extindere pe pagina sa Compute Clients .
Baza de cunoștințe Render discută și despre Dispersed, o rețea de calcul dockerizată de uz general pentru rularea de instrumente precum Houdini, Python și aplicații de suport, alături de fluxurile de lucru Render. Este important de menționat că documentația distinge Dispersed de rețeaua Render în sine: Dispersed rulează calcul containerizat general, în timp ce Render se ocupă de randarea GPU descentralizată specializată. Consultați explicația din baza de cunoștințe Render pentru Dispersed .
Între timp, Akash tratează inteligența artificială ca pe o singură categorie de sarcini de lucru în infrastructură, mai degrabă decât ca pe centrul experienței utilizatorului. Documentația sa pentru GPU include instruirea și inferența LLM, generarea de imagini, procesarea video și configurațiile multi-GPU. De asemenea, documentează suportul pentru interconectarea GPU folosind InfiniBand sau RoCE pentru furnizorii care expun această capacitate, ceea ce este relevant pentru sarcinile de lucru distribuite care necesită comunicare de mare viteză între nodurile GPU.
Deci, distincția utilă nu este „Render face grafică, iar Akash face inteligență artificială”. Ambele pot interacționa cu inteligența artificială. Întrebarea mai bună este dacă volumul de lucru al inteligenței artificiale este încorporat într-un flux de lucru al creatorilor sau se comportă ca o aplicație cloud personalizată.
De cât control ai nevoie?
Randarea abstractizează intenționat o parte mai mare din infrastructură atunci când rămâi în fluxul de lucru de randare acceptat. Acest lucru poate fi valoros. Un artist, în general, este interesat de compatibilitate, VRAM, cadre, mostre, format de ieșire și timpul de finalizare - nu de furnizorul care rulează un pod Kubernetes.
Akash oferă mai multe opțiuni de infrastructură. Descrieți resursele, primiți oferte de la furnizori și alegeți un contract de închiriere. Această flexibilitate este utilă atunci când locația, reputația furnizorului, timpul de funcționare, combinația de resurse sau prețul contează pentru aplicația dvs. De asemenea, înseamnă că chiriașul are o responsabilitate operațională mai mare.
Documentația Akash precizează că furnizorii concurează în funcție de preț, performanță, fiabilitate, locație și caracteristici. API-urile sale expun datele privind disponibilitatea furnizorilor și a GPU-urilor, astfel încât dezvoltatorii pot inspecta ce modele de GPU sunt oferite în prezent și dacă sunt disponibile unități. Disponibilitatea se poate schimba însă; un model listat astăzi de un furnizor nu ar trebui presupus a fi disponibil în permanență. Consultați ghidul de disponibilitate a GPU-urilor .
Prețuri: comparați volumul de muncă finalizat, nu un tarif general
Comparațiile directe de prețuri sunt ușor de utilizat greșit deoarece produsele nu sunt identice. Prețurile oferă o experiență de gestionare creativă a calculului în jurul proiectelor acceptate. Site-ul său oficial descrie prețurile la cerere, fără cheltuieli minime sau angajament inițial. Akash folosește un model de furnizor bazat pe piață, în care ofertele pot diferi în funcție de furnizor, regiune, resurse și cerere.
Consola gestionată de Akash permite utilizatorilor să adauge credite în dolari, care sunt convertite în culise în creditul de calcul ACT al rețelei. Implementările bazate pe portofel utilizează modelul escrow și leasing al rețelei. Detaliile actuale sunt documentate în Cum funcționează finanțarea .
Prin urmare, o comparație corectă utilizează costul total pentru a obține același rezultat util . Pentru o randare, măsurați costul de producere a cadrelor țintă la calitatea necesară. Pentru un serviciu de inferență, măsurați costul de menținere a serviciului disponibil la debitul și latența necesare. Nu comparați o estimare a unui job de randare cu o ofertă orară pentru GPU-ul Akash și nu concluzionați că una este automat mai ieftină; aceasta ignoră cheltuielile generale de flux de lucru, utilizarea, stocarea, crearea de rețele și timpul de inactivitate.
Fiabilitatea și modurile de defecțiune sunt diferite
O sarcină de lucru pentru randare este în mod natural divizibilă. Cadrele sau dalele pot fi adesea redistribuite atunci când un nod se defectează. Designul rețelei și instrumentele de lucru ale Render sunt construite în jurul acestui tip de sarcină de lucru creativă paralelă.
O aplicație cu rulare lungă are diferite probleme de eșec. Pe Akash, aplicația depinde de furnizorul și de contractul de închiriere selectate. Entitățile găzduite ar trebui să evalueze timpul de funcționare al furnizorului, cerințele de persistență, rețeaua și consecințele mutării sarcinilor de lucru. Documentația Akash le spune în mod specific utilizatorilor să evalueze furnizorii în funcție de atribute precum performanța, fiabilitatea și locația.
De aceea, „descentralizat” nu ar trebui interpretat ca „tolerant automat la erori”. Descentralizarea descrie partea de ofertă a calculului. Reziliența la nivel de aplicație depinde în continuare de arhitectură, replicare, copii de rezervă, strategia de implementare și comportamentul furnizorilor individuali.
Care se potrivește cazurilor de utilizare comune?
Animație 3D, efecte vizuale sau vizualizare arhitecturală
Începeți cu Renderizarea. Motoarele sale compatibile, integrările DCC și controalele de lucru orientate pe scenă abordează direct acest flux de lucru. Akash poate rula containere de randare din punct de vedere tehnic, dar veți prelua personal mai multă muncă de orchestrare.
Un LLM persistent sau o API de generare a imaginilor
Începeți cu Akash. Un server de inferență containerizat care necesită un GPU, un endpoint, stocare și un timp de execuție continuu se mapează perfect la modelul de implementare Akash. Inițiativele de calcul ale Render pot fi relevante pentru aplicațiile ecosistemice acceptate, dar găzduirea aplicațiilor brute nu este fluxul de lucru principal al creatorului Render.
Imagini generative în cadrul unui proces de producție creativă
Randarea ar putea fi calea mai simplă. Platforma integrează în prezent instrumente de imagistică generativă alături de creația 3D, ceea ce reduce necesitatea de a asambla singur infrastructura.
Calcul personalizat în lot cu propria imagine Docker
Akash oferă de obicei modelul de infrastructură mai clar. Specificați containerul și resursele și alegeți dintre ofertele furnizorului. Dacă calculul în lot este legat în mod specific de un flux de lucru Rendering/Dispersed acceptat, comparați ambele abordări.
Antrenament GPU multi-nod
Evaluați cu atenție disponibilitatea furnizorilor Akash. Akash documentează acum suportul pentru interconectarea GPU pentru furnizorii care promovează această capacitate, inclusiv RDMA peste InfiniBand sau RoCE. Asta nu înseamnă că fiecare furnizor sau cluster GPU solicitat va fi disponibil în momentul în care aveți nevoie de el. Testați topologia exactă și cerințele de performanță, în loc să presupuneți că o piață descentralizată se comportă ca un cluster hiperscaler dedicat.
Când ar trebui să schimbi abordările?
Folosește rezultatele reale ale sarcinii de lucru ca declanșator. Dacă un flux de lucru Render depune mai mult efort pentru adaptarea logicii neacceptate a aplicației decât pentru randare, mută acea porțiune la calcul general. Dacă o implementare Akash necesită o orchestrare personalizată substanțială doar pentru a reproduce un flux de lucru pe care Render îl acceptă deja nativ, testează Render în schimb.
Renunțați la o conductă de randare specializată atunci când aveți nevoie de servicii persistente, containere arbitrare, baze de date, porturi personalizate sau un control mai amplu al infrastructurii.
Renunțați la infrastructura brută atunci când majoritatea lucrărilor de inginerie constă în ambalare, programare și colectarea unei randări creative standard pe care o platformă special concepută o gestionează deja.
Reevaluați oricare dintre opțiuni atunci când modelul GPU, memoria, interconectarea, regiunea sau disponibilitatea necesare nu sunt disponibile în mod constant.
Faceți o evaluare comparativă înainte de a vă angaja atunci când costul depinde în mare măsură de utilizarea GPU-ului, volumul de transfer, complexitatea scenei, dimensiunea modelului sau timpul de inactivitate.
Concluzia
Render și Akash sunt ambele exemple de calcul descentralizat care a devenit util pentru sarcini de lucru care odinioară necesitau cumpărarea de GPU-uri locale scumpe sau angajarea unei capacități centralizate în cloud, dar abordează problema din direcții diferite.
Randarea abstractizează infrastructura în joburi GPU axate pe creator. Este prima alegere mai naturală pentru randarea 3D, efectele vizuale și fluxurile de lucru integrate cu conținut generativ acceptate. Akash expune o piață cloud mai largă, unde dezvoltatorii selectează furnizorii și rulează aplicații containerizate cu resurse configurabile de CPU, memorie, stocare, rețea și GPU.
Dacă întrebarea ta este „Cum termin eficient această randare sau această lucrare GPU creativă?”, începe cu Randarea. Dacă întrebarea este „Unde pot rula această aplicație containerizată sau serviciu GPU cu control la nivel de infrastructură?”, începe cu Akash. Pentru sarcinile de lucru AI care se află între aceste categorii, testează fluxul de lucru real pe ambele și compară rezultatul final - performanță, fiabilitate, efort operațional și cost total - nu doar disponibilitatea anunțată a GPU-urilor descentralizate.