Startseite
» Nachrichten
»
Render vs. Akash Network: Welches dezentrale Rechenmodell passt zu Ihrer Arbeitslast?
Render vs. Akash Network: Welches dezentrale Rechenmodell passt zu Ihrer Arbeitslast?
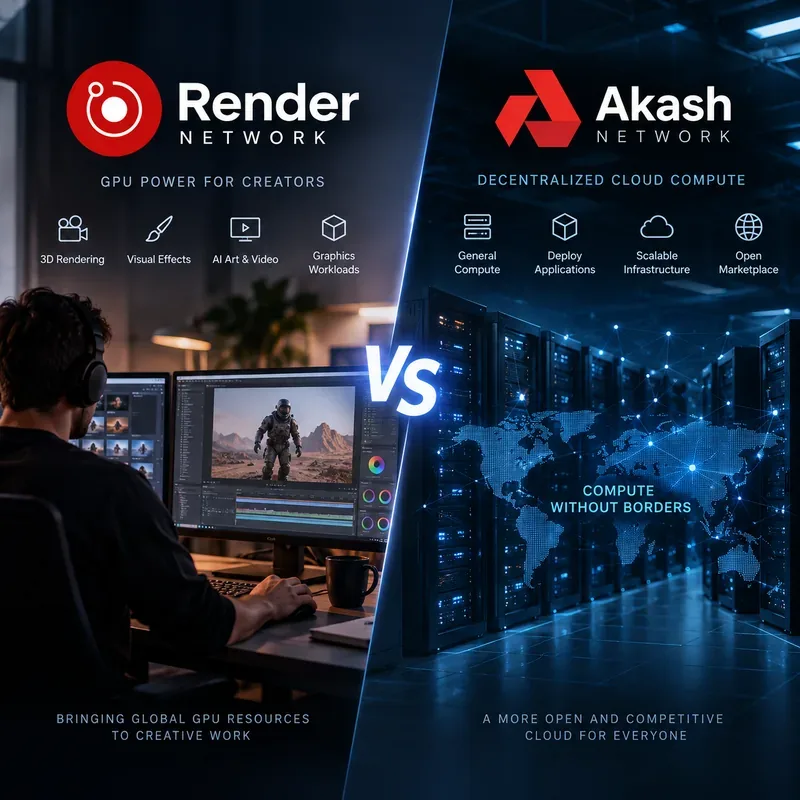
Der wichtigste Unterschied liegt in der Workload-Anpassung: Render Network ist am stärksten, wenn Sie eine auf Kreative ausgerichtete GPU-Pipeline für 3D-Rendering, visuelle Effekte, räumliche Inhalte und integrierte generative Medien benötigen, während Akash Network eher einem allgemeinen dezentralen Cloud-Marktplatz ähnelt, auf dem Sie Container bereitstellen und CPU, Arbeitsspeicher, Speicher, Netzwerk und GPUs von konkurrierenden Anbietern mieten.
Das bedeutet, dass es keine eindeutige Antwort auf die Frage „Rendern oder Akash?“ gibt. Ein Studio, das einen Octane-, Redshift- oder Blender Cycles-Renderprozess abschließen möchte, steht vor einem anderen Problem als ein Entwickler, der eine Inferenz-API, eine datenbankgestützte Anwendung oder einen benutzerdefinierten CUDA-Container am Laufen halten muss. Das bessere Netzwerk ist dasjenige, dessen Betriebsmodell zum jeweiligen Anwendungsfall passt.
Render Network konzentriert sich auf GPU-intensive kreative Workflows, während Akash Network einen breiteren Markt für containerisierte Recheninfrastruktur erschließt.
Render vs. Akash in einer Tabelle
Frage
Render-Netzwerk
Akash-Netzwerk
Primärstärke
Verteiltes GPU-Rendering und auf Kreative ausgerichtete generative Workflows
Universelle dezentrale Cloud-Infrastruktur
Typische Arbeitseinheit
Szene rendern, Frame-Job, kreativer oder KI-gestützter Workflow
Containerisierte Bereitstellung beschrieben mit Anforderungen an CPU, RAM, Speicher, GPU und Netzwerk
Die Plattform plant kompatible Jobs auf den verschiedenen Netzwerkknoten.
Anbieter geben Angebote für einen Einsatz ab; der Mieter nimmt ein Angebot an und schließt einen Mietvertrag ab.
Wenn es sich am einfachsten anfühlt
Sie verwenden bereits ein unterstütztes Kreativtool und möchten rendern, ohne eine Cloud-Infrastruktur aufzubauen.
Sie haben bereits einen Container und wünschen sich eine cloudähnliche Bereitstellungskontrolle.
Wählen Sie „Rendern“, wenn das Ergebnis der kreative Prozess selbst ist.
Render Network wurde für High-End-GPU-Rendering entwickelt. Die aktuelle offizielle Website positioniert den Dienst rund um OctaneRender, Redshift und Blender Cycles sowie generative KI-Bildbearbeitungswerkzeuge. Das Netzwerk dokumentiert außerdem Integrationen mit führender Software zur Erstellung digitaler Inhalte, darunter Blender, Cinema 4D, Houdini, Maya, 3ds Max, Unity und Unreal Engine. Besuchen Sie die offizielle Website von Render Network und die Seite mit den offiziellen Integrationen .
Diese Spezialisierung ist wichtig. Ein Creator mietet nicht einfach nur eine GPU. Der Workflow umfasst Szenenvorbereitung, Jobübermittlung, Kostenschätzung, Rendering und Ausgabeabruf. Für Octane-Workflows erklärt die Dokumentation von Render, dass eine Szene als ORBX-Datei verpackt und an das Netzwerk gesendet werden kann. Render bietet außerdem Steuerelemente wie minimalen VRAM und maximale GPU-Anzahl, um komplexe Szenen den passenden Nodes zuzuordnen. Die offizielle Dokumentation zur Szenenvorbereitung und der Leitfaden für erweiterte Jobparameter beschreiben dieses Modell detailliert.
Ein konkretes Putzbeispiel
Stellen Sie sich ein Motion-Design-Studio vor, das eine Cinema-4D-Sequenz mit 2.000 Einzelbildern hat, die in Redshift korrekt gerendert wird, auf lokalen Workstations aber zu lange dauern würde. Das Studio benötigt weder einen permanenten Webserver noch die Administration von Kubernetes. Es benötigt fertige Einzelbilder. Render eignet sich ideal für diese Anforderung, da die Arbeit als Rendering-Auftrag und nicht als Cloud-Bereitstellung behandelt werden kann.
Der praktische Qualitätstest ist einfach: Lässt sich die Szene in einem unterstützten Workflow vorbereiten, erfolgreich übertragen und in akzeptabler Zeit und zu akzeptablen Kosten fertigstellen, während gleichzeitig die erwarteten Frames erzeugt werden? Wenn ja, ist die spezialisierte Pipeline von Vorteil. Muss das Studio hingegen parallel zum Renderprozess unabhängige, langlaufende Dienste ausführen, ist dies ein Hinweis darauf, eine allgemeinere Rechenplattform zu evaluieren.
Wählen Sie Akash, wenn Sie Infrastruktur und nicht eine Rendering-Pipeline benötigen.
Akash verfolgt einen anderen Ansatz. Die offizielle Dokumentation beschreibt einen dezentralen Marktplatz, der Nutzer mit Rechenbedarf mit Infrastrukturanbietern verbindet. Ein Deployment spezifiziert Dienste und benötigte Ressourcen; eine Bestellung wird eröffnet; Anbieter geben Gebote ab; der Nutzer wählt ein Gebot aus; und die Anwendung läuft im Rahmen eines Leases. Siehe die Dokumentation zum Akash-Deployment-Lebenszyklus .
Die Bereitstellungsdefinition ähnelt eher einer Cloud-Infrastruktur als einer Render-Warteschlange. Mit Akashs Stack Definition Language (SDL) kann ein Mandant Container-Images, CPU-, Arbeitsspeicher-, Speicher-, Port- und GPU-Anforderungen beschreiben. Anbieter können CPU- und GPU-Rechenleistung, persistenten oder temporären Speicher, Netzwerkverbindungen und optionale IP-Adressen anbieten. Die Anbieter- und Adressdokumentation erläutert die Funktionsweise dieser Ressourcen und Vereinbarungen.
Ein konkretes Beispiel aus Akash
Angenommen, ein Entwickler hat eine API zur Image-Generierung in Docker verpackt. Der Dienst benötigt eine NVIDIA-GPU, mindestens 16 GB GPU-Speicher, mehrere CPU-Kerne, RAM, persistenten Speicher und einen öffentlichen Endpunkt. Der Entwickler möchte, dass der Dienst nach Abschluss eines Batch-Jobs online bleibt und nicht verschwindet.
Das ist strukturell ein Problem im Akash-Stil. Der Entwickler kann eine GPU-Bereitstellung anfordern, kompatible Angebote von Anbietern auswählen, den Container ausführen und während der Laufzeit der Lizenz bezahlen. Die aktuelle GPU-Dokumentation von Akash behandelt explizit KI-Training, Inferenz, Rendering und wissenschaftliche Workloads, einschließlich modellspezifischer GPU-Anforderungen und Multi-GPU-Konfigurationen. Siehe den offiziellen Leitfaden für GPU-Bereitstellungen .
Und wie sieht es mit KI aus? Die beiden Netzwerke überschneiden sich zunehmend.
Im Bereich der künstlichen Intelligenz (KI) werden die Vergleiche weniger eindeutig. Render beschränkt sich nicht mehr nur auf das traditionelle Frame-Rendering. Die aktuelle Plattform umfasst generative Bildbearbeitungswerkzeuge, und die Initiative „Compute Client“ unterstützt maschinelles Lernen, Inferenz, Feinabstimmung und generative KI-Anwendungen von Drittanbietern. Render beschreibt diese Erweiterung auf seiner Compute-Clients-Seite .
Die Wissensdatenbank von Render beschreibt auch Dispersed, ein universelles, dockerisiertes Rechennetzwerk zum Ausführen von Tools wie Houdini, Python und zugehörigen Anwendungen in Verbindung mit Render-Workflows. Wichtig ist, dass die Dokumentation Dispersed vom Render-Netzwerk selbst unterscheidet: Dispersed führt allgemeine containerisierte Rechenprozesse aus, während Render spezialisiertes, dezentrales GPU-Rendering übernimmt. Weitere Informationen zu Dispersed finden Sie in der Wissensdatenbank von Render .
Akash hingegen betrachtet KI als eine Kategorie von Infrastruktur-Workloads und nicht als zentralen Bestandteil der Benutzererfahrung. Die GPU-Dokumentation umfasst LLM-Training und -Inferenz, Bildgenerierung, Videoverarbeitung und Multi-GPU-Konfigurationen. Sie dokumentiert außerdem die Unterstützung von GPU-Verbindungen mittels InfiniBand oder RoCE für Anbieter, die diese Funktion bereitstellen. Dies ist relevant für verteilte Workloads, die eine Hochgeschwindigkeitskommunikation zwischen GPU-Knoten erfordern.
Die sinnvolle Unterscheidung lautet also nicht: „Renderer erstellt Grafiken und Akash KI.“ Beide können KI nutzen. Die wichtigere Frage ist, ob die KI-Workload in einen Erstellungsprozess eingebettet ist oder sich wie eine benutzerdefinierte Cloud-Anwendung verhält.
Wie viel Kontrolle benötigen Sie?
Render abstrahiert bewusst mehr von der Infrastruktur, solange man innerhalb des unterstützten Rendering-Workflows bleibt. Das kann von Vorteil sein. Einem Künstler sind in der Regel Kompatibilität, VRAM, Frames, Samples, Ausgabeformat und Fertigstellungszeit wichtig – nicht, welcher Anbieter einen Kubernetes-Pod ausführt.
Akash bietet mehr Infrastrukturoptionen. Sie beschreiben Ressourcen, erhalten Angebote von Anbietern und wählen einen Mietvertrag. Diese Flexibilität ist besonders nützlich, wenn Standort, Anbieterreputation, Verfügbarkeit, Ressourcenkombination oder Preis für Ihre Anwendung wichtig sind. Gleichzeitig bedeutet dies aber auch, dass der Mieter mehr operative Verantwortung trägt.
Laut Akash-Dokumentation konkurrieren Anbieter über Preis, Leistung, Zuverlässigkeit, Standort und Funktionen. Die APIs stellen Daten zur Anbieter- und GPU-Verfügbarkeit bereit, sodass Entwickler prüfen können, welche GPU-Modelle aktuell angeboten werden und ob Einheiten verfügbar sind. Die Verfügbarkeit kann sich jedoch ändern; ein heute von einem Anbieter gelistetes Modell ist nicht zwangsläufig dauerhaft verfügbar. Weitere Informationen finden Sie im Leitfaden zur GPU-Verfügbarkeit .
Preisgestaltung: Vergleichen Sie die tatsächliche Arbeitsleistung, nicht den beworbenen Preis.
Direkte Preisvergleiche sind leicht zu missbrauchen, da die Produkte nicht identisch sind. Render bietet ein verwaltetes Creative-Computing-Erlebnis für unterstützte Aufträge. Auf der offiziellen Website wird die bedarfsgerechte Preisgestaltung ohne Mindestbestellwert oder Vorabverpflichtung beschrieben. Akash nutzt ein marktorientiertes Anbietermodell, bei dem die Gebote je nach Anbieter, Region, Ressourcen und Nachfrage variieren können.
Die verwaltete Konsole von Akash ermöglicht es Nutzern, Guthaben in US-Dollar hinzuzufügen, das im Hintergrund in ACT-Rechenguthaben des Netzwerks umgewandelt wird. Wallet-basierte Bereitstellungen nutzen das Treuhand- und Leasingmodell des Netzwerks. Die aktuellen Details sind unter „ So funktioniert die Finanzierung“ dokumentiert .
Ein fairer Vergleich berücksichtigt daher die Gesamtkosten für das gleiche Ergebnis . Messen Sie bei einem Rendering die Kosten für die Erstellung der Zielframes in der geforderten Qualität. Messen Sie bei einem Inferenzdienst die Kosten für die Aufrechterhaltung des Dienstes mit dem erforderlichen Durchsatz und der erforderlichen Latenz. Vergleichen Sie nicht die Kostenschätzung für einen Rendering-Auftrag mit einem stündlichen Angebot für Akash-GPUs und schließen Sie daraus nicht automatisch auf einen günstigeren Ansatz; dabei werden Workflow-Overhead, Auslastung, Speicherplatz, Netzwerkressourcen und Leerlaufzeiten außer Acht gelassen.
Zuverlässigkeit und Ausfallarten sind unterschiedlich
Eine Rendering-Last lässt sich naturgemäß aufteilen. Frames oder Tiles können oft neu verteilt werden, wenn ein Knoten ausfällt. Das Netzwerkdesign und die Job-Tools von Render sind genau auf diese Art von paralleler, kreativer Arbeitslast ausgelegt.
Eine Anwendung mit langer Laufzeit hat andere Ausfallrisiken. Auf Akash hängt die Anwendung vom gewählten Provider und der gewählten Lease ab. Mandanten sollten die Verfügbarkeit des Providers, die Anforderungen an die Datenpersistenz, die Netzwerkverbindung und die Folgen einer Workload-Verschiebung bewerten. Die Akash-Dokumentation empfiehlt Nutzern ausdrücklich, Provider anhand von Kriterien wie Leistung, Zuverlässigkeit und Standort zu bewerten.
Deshalb sollte „dezentralisiert“ nicht mit „automatisch fehlertolerant“ verwechselt werden. Dezentralisierung beschreibt die Angebotsseite der Rechenleistung. Die Ausfallsicherheit von Anwendungen hängt weiterhin von Architektur, Replikation, Datensicherung, Bereitstellungsstrategie und dem Verhalten einzelner Anbieter ab.
Welche eignet sich für gängige Anwendungsfälle?
3D-Animation, visuelle Effekte oder Architekturvisualisierung
Beginnen Sie mit Render. Die unterstützten Engines, DCC-Integrationen und szenenorientierten Jobsteuerungen sind direkt auf diesen Workflow abgestimmt. Akash kann zwar technisch gesehen Rendering-Container ausführen, die Orchestrierung müsste jedoch größtenteils selbst übernommen werden.
Eine persistente LLM- oder Bildgenerierungs-API
Beginnen Sie mit Akash. Ein containerisierter Inferenzserver, der eine GPU, einen Endpunkt, Speicher und eine kontinuierliche Laufzeitumgebung benötigt, lässt sich nahtlos in das Bereitstellungsmodell von Akash integrieren. Die Recheninitiativen von Render können für Anwendungen im unterstützten Ökosystem relevant sein, das reine Anwendungshosting gehört jedoch nicht zum Kern-Workflow von Render Creator.
Generative Bildsprache innerhalb eines kreativen Produktionsprozesses
Rendern könnte der einfachere Weg sein. Die Plattform integriert derzeit generative Bildbearbeitungswerkzeuge neben der 3D-Erstellung, wodurch der Bedarf, die Infrastruktur selbst aufzubauen, reduziert wird.
Benutzerdefinierte Batchverarbeitung mit Ihrem eigenen Docker-Image
Akash bietet in der Regel das übersichtlichere Infrastrukturmodell. Sie legen Container und Ressourcen fest und wählen aus den Angeboten der Anbieter. Wenn die Batch-Verarbeitung speziell an einen unterstützten Render/Dispersed-Workflow gebunden ist, vergleichen Sie beide Ansätze.
Multi-Node-GPU-Training
Prüfen Sie die Verfügbarkeit von Akash-Anbietern sorgfältig. Akash dokumentiert nun die GPU-Interconnect-Unterstützung für Anbieter, die diese Funktion anbieten, einschließlich RDMA über InfiniBand oder RoCE. Das bedeutet jedoch nicht, dass jeder Anbieter oder jeder angeforderte GPU-Cluster zum gewünschten Zeitpunkt verfügbar ist. Testen Sie daher die genaue Topologie und die Leistungsanforderungen, anstatt anzunehmen, dass sich ein dezentraler Marktplatz wie ein dedizierter Hyperscaler-Cluster verhält.
Wann sollte man den Ansatz wechseln?
Nutzen Sie die tatsächlichen Arbeitslastergebnisse als Auslöser. Wenn ein Render-Workflow mehr Aufwand für die Anpassung nicht unterstützter Anwendungslogik als für das Rendering selbst benötigt, verlagern Sie diesen Teil in die allgemeine Rechenumgebung. Wenn eine Akash-Bereitstellung umfangreiche benutzerdefinierte Orchestrierung erfordert, nur um einen Workflow zu reproduzieren, den Render bereits nativ unterstützt, testen Sie stattdessen Render.
Wechseln Sie von einer spezialisierten Rendering-Pipeline weg, wenn Sie persistente Dienste, beliebige Container, Datenbanken, benutzerdefinierte Ports oder eine umfassendere Infrastrukturkontrolle benötigen.
Weg von der reinen Infrastruktur, wenn der Großteil der Ingenieursarbeit aus dem Verpacken, Planen und Sammeln eines standardisierten kreativen Renderings besteht, das bereits von einer eigens dafür entwickelten Plattform übernommen wird.
Eine der beiden Optionen sollte erneut geprüft werden, wenn das erforderliche GPU-Modell, der Speicher, die Verbindung, die Region oder die Verfügbarkeit nicht durchgängig gegeben sind.
Führen Sie Benchmarks durch, bevor Sie sich festlegen , wenn die Kosten stark von der GPU-Auslastung, dem Übertragungsvolumen, der Szenenkomplexität, der Modellgröße oder der Leerlaufzeit abhängen.
Fazit
Render und Akash sind beides Beispiele dafür, wie dezentrales Rechnen für Arbeitslasten nützlich wird, für die man früher teure lokale GPUs kaufen oder zentralisierte Cloud-Kapazitäten nutzen musste, aber sie gehen das Problem aus unterschiedlichen Richtungen an.
Render abstrahiert die Infrastruktur in GPU-basierte Prozesse, die speziell auf die Bedürfnisse von Kreativen zugeschnitten sind. Es ist die naheliegende erste Wahl für unterstütztes 3D-Rendering, VFX und integrierte Workflows für generative Inhalte. Akash bietet einen breiteren Cloud-Marktplatz, auf dem Entwickler Anbieter auswählen und containerisierte Anwendungen mit konfigurierbaren CPU-, Arbeitsspeicher-, Speicher-, Netzwerk- und GPU-Ressourcen ausführen können.
Wenn Ihre Frage lautet: „Wie schließe ich diesen Render- oder Grafik-GPU-Job effizient ab?“, beginnen Sie mit Render. Wenn sie lautet: „Wo kann ich diese containerisierte Anwendung oder diesen GPU-Dienst mit Infrastrukturkontrolle ausführen?“, beginnen Sie mit Akash. Bei KI-Workloads, die zwischen diesen Kategorien liegen, testen Sie die reale Pipeline auf beiden Plattformen und vergleichen Sie das Endergebnis – Leistung, Zuverlässigkeit, Betriebsaufwand und Gesamtkosten – und nicht nur die beworbene Verfügbarkeit dezentraler GPUs.